Özet: Apache Hadoop, petabayt ölçeğindeki yapılandırılmamış veriyi emtia donanım üzerinde dağıtık olarak saklayan ve işleyen açık kaynaklı bir çerçevedir; HDFS, YARN ve MapReduce ana bileşenleridir. Modern mimaride Hadoop genellikle HDFS + YARN + Apache Spark kombinasyonu olarak kullanılır ve giderek S3 uyumlu nesne depolama + Spark + Iceberg paradigmasına evrilmektedir. Türkiye'de KVKK uyumlu yerli analitik için yönetilen Hadoop & Spark hizmeti operasyonel yükü ortadan kaldırır.
Ana noktalar:
- Hadoop dağıtık, yatay ölçeklenir ve emtia donanım üzerinde çalışan açık kaynaklı bir büyük veri çerçevesidir.
- Üç temel bileşen: HDFS (depolama), YARN (kaynak yönetimi) ve MapReduce (klasik işlem motoru).
- Spark, MapReduce'un disk darboğazını ortadan kaldıran bellek-içi işlem motorudur ve iteratif iş yüklerini 10-100 kat hızlandırır.
- Modern mimaride HDFS yerine S3 uyumlu nesne depolama; storage ve compute ayrılarak %40-70 maliyet tasarrufu mümkün.
- KVKK kapsamındaki kişisel veri analitiği için yerli (İstanbul) Hadoop kümesi veri ikameti ve uyum avantajı sağlar.
- Yönetilen Hadoop, NameNode HA, patch, Kerberos ve izleme gibi karmaşıklıkları sağlayıcıya devreder.
Şirketler her gün petabaytlarca yapılandırılmamış veri üretiyor: web sunucu logları, mobil uygulama olayları, IoT cihazlarından gelen telemetri, finansal işlem akışları ve makine öğrenmesi eğitim setleri. Bu hacmi geleneksel ilişkisel veritabanı ile saklamak ve işlemek hem teknik hem ekonomik açıdan sürdürülemez. Apache Hadoop, tam da bu noktada büyük veri sorununa açık kaynaklı, dağıtık ve yatay ölçeklenir bir çözüm olarak öne çıktı.
Bu rehber, veri mühendisleri, çözüm mimarları ve analitik ekibi yöneticileri için yazıldı. Hadoop'un ne olduğunu, mimari bileşenlerini, ekosistem projelerini, Spark ile ilişkisini, modern lakehouse paradigmasını, kurumsal kullanım senaryolarını ve self-managed küme yönetimi ile managed hizmet arasındaki seçimi pratik açıdan ele alıyoruz. Türkiye'deki şirketler için KVKK uyumlu yerli analitik altyapısının önemi de ayrı bir başlık altında değerlendirildi.
Sonunda, kendi veri stratejiniz için Hadoop'a yatırım yapmanın anlamlı olup olmadığına ve hangi modelle (kendi sunucularınızda mı, bulutta mı, yönetilen olarak mı) ilerleyeceğinize dair somut bir karar çerçeveniz olacak.
Hadoop Nedir ve Neden Önemlidir?
Apache Hadoop'un tanımı ve doğuşu
Apache Hadoop, büyük veri kümelerinin dağıtık olarak saklanmasını ve işlenmesini sağlayan açık kaynaklı bir yazılım çerçevesidir. Apache Software Foundation çatısı altında geliştirilen proje, Java ile yazılmıştır ve emtia donanım üzerinde çalışacak şekilde tasarlanmıştır. Yani pahalı bir mainframe yerine, ucuz ve sıradan sunuculardan oluşan bir küme ile petabayt ölçeğinde veri yönetmenize olanak tanır.
Hadoop'un doğuşu 2000'lerin başına dayanır. Doug Cutting ve Mike Cafarella, Apache Nutch arama motoru projesi için ölçeklenebilir bir altyapı ararken Google'ın yayımladığı GFS (Google File System) ve MapReduce makalelerinden ilham aldı. Cutting Yahoo!'ya katıldıktan sonra proje hızla büyüdü; 2008'de Apache'nin üst düzey projelerinden biri oldu. Adını ise Cutting'in oğlunun oyuncak filinden alır.
Büyük veri (big data) probleminin çözümü olarak Hadoop
Geleneksel ilişkisel veritabanları (RDBMS) tek bir sunucuda dikey ölçekleme prensibine dayanır. Tek sunucunun CPU, RAM ve disk kapasitesi sınıra ulaştığında ya daha güçlü donanıma geçilir (pahalı ve sonludur) ya da sharding gibi karmaşık mimari değişiklikleri yapılır. Hadoop bu paradigmayı tersine çevirdi: işi tek büyük makine yerine yüzlerce küçük makineye bölmek, hem maliyet hem güvenilirlik açısından daha sürdürülebilir bir mimari sunar.
Büyük veri tanımının üç V'si — Volume (hacim), Velocity (hız) ve Variety (çeşitlilik) — Hadoop'un çözmek için tasarlandığı sorunu özetler. Tek başına TB ölçeği bir veritabanını zorlamasa da, çok kaynaklı yarı yapılandırılmış akışın eş zamanlı saklanması, işlenmesi ve analiz edilmesi farklı bir mimari gerektirir. Hadoop bu mimariyi standartlaştırdı.
Hadoop'un kurumsal etkisi
2010'lu yıllarda Hadoop, "big data" deyiminin pratik karşılığı hâline geldi. Bankalar dolandırıcılık tespit ettikleri akışlarını, telekom şirketleri abone davranış analizini, e-ticaret platformları öneri motorlarını Hadoop kümeleri üzerinde çalıştırdı. Veri ambarı (data warehouse) projelerinin önemli bir kısmı, ham veri depolama katmanı olarak HDFS'i ön gördü.
Bugün Hadoop'un rolü değişmiş olsa da (Spark, S3 ve lakehouse formatları ile birlikte kullanılıyor), büyük veri kavramının kurumsal dünyaya girmesinde merkezi rol oynadı. IDC'nin küresel BT harcaması analizlerine göre büyük veri ve analitik altyapısı son yıllarda kurumsal yatırımların öncelikli kalemlerinden biridir; veri mühendisliği disiplini büyük ölçüde Hadoop ekosisteminden gelen pratiklerle şekillendi.
Hadoop Mimarisi ve Temel Bileşenleri
HDFS (Hadoop Distributed File System)
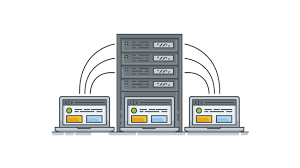
HDFS, Hadoop'un dağıtık dosya sistemidir. Büyük dosyaları (genellikle 128 MB veya 256 MB) bloklara böler ve bu blokları küme içindeki birden çok düğüme replikalı (varsayılan üç kopya) olarak dağıtır. Bir düğüm devre dışı kalsa bile veri kaybolmaz; replikalar diğer düğümlerde mevcuttur ve sistem otomatik olarak eksik replikaları yeniden oluşturur.
HDFS, "write once, read many" prensibiyle tasarlanmıştır. Yazma sonrası dosya değiştirilmez; sadece okuma ve append işlemleri optimize edilmiştir. Bu pratik kısıt, MapReduce gibi büyük ölçekli batch işlemler için ideal bir altyapı sağlar ancak transaksiyonel iş yükleri için uygun değildir.
YARN — kaynak yönetimi
YARN (Yet Another Resource Negotiator), Hadoop 2.0 ile gelen kaynak yönetim katmanıdır. CPU, RAM ve disk gibi küme kaynaklarını, üzerinde çalışan farklı uygulamalara (MapReduce, Spark, Flink, Tez) tahsis eder. Önceki sürümlerde kaynak yönetimi MapReduce ile sıkı bağlıydı; YARN sayesinde Hadoop kümesi çoklu işlem motorunu eş zamanlı çalıştırabilen bir genel amaçlı veri platformuna dönüştü.
YARN üç temel bileşenden oluşur: ResourceManager (küme genelinde kaynak tahsisi), NodeManager (her düğümdeki yerel kaynak yönetimi) ve ApplicationMaster (her iş için ayrı, görev yaşam döngüsünü yönetir). Bu mimari, kümenin farklı önceliklerdeki iş yüklerini çakışma olmadan paralel çalıştırmasına izin verir.
MapReduce — klasik işlem motoru
MapReduce, Hadoop'un orijinal işlem modelidir. Veri üzerinde iki aşamalı bir hesaplama yapar: Map aşaması her veri parçasını işleyerek anahtar-değer çiftleri üretir; Reduce aşaması bu çiftleri anahtar bazında toplar ve nihai sonucu üretir. Bu basit model, çok büyük veri kümeleri üzerinde paralel hesaplamayı standartlaştırdı.
Ancak MapReduce'un disk-tabanlı yapısı ve her adımda ara sonucu HDFS'e yazma zorunluluğu, iteratif algoritmalarda (makine öğrenmesi, graf işlemleri) ciddi performans darboğazı yarattı. Bu sınır, Spark'ın doğmasının ana sebeplerinden biri oldu.
NameNode ve DataNode rolleri
HDFS mimarisinde iki tür düğüm vardır. NameNode, dosya sistemi metadata'sını tutar: hangi dosya hangi bloklara bölündü, her blok hangi DataNode'larda replikalı, dizin yapısı nedir. Tek bir NameNode tüm metadata'yı RAM'de tuttuğundan, çok küçük dosyalardan oluşan büyük bir kümede bellek sınırı bir darboğaz olabilir.
DataNode'lar gerçek veri bloklarını saklar. Düzenli heartbeat sinyali ile NameNode'a kendi durumlarını ve sakladıkları blok listesini bildirir. NameNode bir DataNode'dan heartbeat alamadığında ilgili blokları küme içinde başka DataNode'lara replikatif olarak çoğaltır; bu sayede tek düğüm arızasında veri kaybı yaşanmaz. Üretim ortamlarında NameNode için yüksek erişilebilirlik (HA) yapılandırması zorunludur.
Hadoop Ekosistemi: Yardımcı Projeler
Apache Hive — SQL üzerinde Hadoop
Apache Hive, HDFS üzerinde saklanan verileri SQL benzeri bir dilde (HiveQL) sorgulamayı sağlar. Arka planda sorguyu MapReduce, Tez veya Spark işlerine çevirir. Veri analistleri ve BI ekipleri için Hive, Hadoop dünyasının giriş kapısı olmuştur; yeni bir programlama dili öğrenmeye gerek kalmadan büyük veriye SQL ile erişilebilir.
Hive tablolarının metadata'sı Hive Metastore'da saklanır. Bu metastore zamanla Hadoop ekosisteminin standart kataloğu hâline geldi; Spark, Presto, Trino gibi modern motorlar da Hive Metastore'u tablo katalogu olarak kullanır.
Apache HBase — NoSQL veritabanı
HBase, Google BigTable'dan ilham alan, HDFS üzerinde çalışan dağıtık ve sütun ailesi tabanlı (column-family) bir NoSQL veritabanıdır. Düşük gecikmeli rastgele okuma ve yazma operasyonlarını destekler; HDFS'in batch odaklı yapısını gerçek zamanlı erişim ihtiyacıyla tamamlar. Time-series veri, kullanıcı oturum verisi ve büyük ölçekli OLTP'ye yakın iş yükleri için tercih edilir.
Apache Sqoop ve Flume — veri ingestion
Sqoop, ilişkisel veritabanlarından (Oracle, MySQL, PostgreSQL, SQL Server) HDFS veya Hive'a toplu veri transferi için tasarlandı. JDBC üzerinden çalışır ve transferi MapReduce iş olarak paralelleştirir. Flume ise log ve olay akışlarının gerçek zamanlı toplanmasına odaklanır; web sunucu logları, uygulama olayları gibi sürekli akan veri kaynaklarından HDFS'e güvenilir ingestion sağlar.
Bu iki proje hâlâ kullanılmakla birlikte, modern mimarilerde yerlerini büyük ölçüde Apache Kafka + Kafka Connect, Debezium ve Airbyte gibi araçlara bırakmıştır.
Apache Oozie — iş akışı orkestrasyonu
Oozie, Hadoop iş akışlarını planlamak ve birbirine bağlamak için kullanılan bir orkestrasyon motorudur. Bir analitik pipeline tipik olarak ingestion → temizleme → dönüştürme → toplama → raporlama gibi sıralı adımlardan oluşur; Oozie bu adımları DAG (directed acyclic graph) olarak tanımlayıp zamanlamanızı sağlar.
Apache Airflow son yıllarda orkestrasyon dünyasında baskın hâle gelse de, eski Hadoop kurulumlarında Oozie hâlâ yaygın olarak görülür.
Hadoop vs Apache Spark
MapReduce'un sınırları ve Spark'ın yükselişi
MapReduce, basit ve dayanıklı bir model olmakla birlikte, her aşama arasında ara sonucu diske yazma zorunluluğu, iteratif algoritmalarda performansı ciddi şekilde düşürdü. K-means kümeleme veya PageRank gibi onlarca iterasyon gerektiren işler MapReduce'ta dakikalar yerine saatler sürdü.
Apache Spark, 2009'da Berkeley AMPLab'de bu sorunu çözmek üzere doğdu. Veriyi mümkün olduğunca bellek içinde tutar, sadece gerektiğinde diske yazar; aynı veri üzerinde art arda yapılan işlemleri 10-100 kat hızlandırır. Bunun yanında Spark SQL, MLlib (makine öğrenmesi), GraphX (graf işleme) ve Structured Streaming (akış işleme) modülleri ile MapReduce'tan çok daha geniş bir kullanım yelpazesi sunar.
Bellek-içi (in-memory) işlem avantajları
Spark'ın RDD (Resilient Distributed Dataset) ve sonrasında gelen DataFrame/Dataset soyutlamaları, veri kümelerini küme bellekleri arasında dağıtık olarak tutar. İşlem zincirinde ara sonuçlar diske yazılmaz; bir önceki adımın çıktısı doğrudan sonraki adımın girişi olur. Bu mimari, ETL ve makine öğrenmesi iş yüklerinde MapReduce'a göre çok büyük hız avantajı sağlar.
Spark aynı zamanda lazy evaluation prensibi ile çalışır: dönüşümler tanımlandığında çalıştırılmaz, ancak bir aksiyon (count, collect, save) tetiklendiğinde optimize edilmiş bir yürütme planı oluşturulur. Bu, gereksiz veri taramalarını ortadan kaldırır.
Bugünün standardı: HDFS + Spark kombinasyonu
Modern büyük veri mimarisinde "Hadoop" deyince çoğu zaman HDFS (depolama) + YARN (kaynak yönetimi) + Spark (işlem motoru) üçlüsü kastedilir. MapReduce kodu yazmak artık nadirdir; veri mühendisleri PySpark, Scala Spark veya Spark SQL ile çalışır.
Spark, Hadoop dışında da çalışabilir: Kubernetes üzerinde, standalone modda veya bulut yönetilen hizmetlerinde. CNCF'nin bulut yerel ekosistem raporlarına göre Kubernetes üzerinde Spark çalıştırmak hızla yaygınlaşan bir pratiktir. HDFS ise yerini giderek S3 uyumlu nesne depolamaya bırakıyor; yine de Hadoop ekosistemi (Hive Metastore, YARN, HDFS) Spark dağıtımının en olgun ortamlarından biri olarak büyük kurumlarda yaygın kullanımdadır.
Modern Veri Mimarisi: Data Lake ve Lakehouse
HDFS vs object storage (S3 uyumlu)
Klasik Hadoop mimarisinde HDFS depolama ve compute aynı düğümlerde çalışır (data locality). Bu hesap-veri yakınlığı eskiden bir performans avantajıydı; bugün ağ hızlarının (25-100 Gbps) ve nesne depolamanın olgunluğu sayesinde, depolama ile hesabı ayırmak (decoupled storage and compute) yeni standart hâline geldi.
S3 uyumlu nesne depolama (AWS S3, MinIO, yerel S3 sağlayıcılar) HDFS'in büyük dosya saklama avantajını sunar, üstelik bağımsız ölçekleme imkânı verir. Compute kümeniz pikte ölçeklenir, sabit zamanlarda küçülür; depolama 7/24 sabit kalır. Bu mimari hem operasyonel olarak daha esnek, hem maliyet açısından çoğu zaman daha verimlidir.
Apache Iceberg ve Delta Lake formatları
Apache Iceberg, Delta Lake ve Apache Hudi gibi modern tablo formatları, nesne depolama üzerinde ACID transaksiyonu, şema evrimi, time-travel sorguları ve verimli partition yönetimi sunar. Bu formatlar, "data lake" üzerinde "data warehouse" disiplinini kurabilen lakehouse paradigmasının temelidir.
Iceberg ve Delta Lake ile, eskiden ETL ile veri ambarına taşımanız gereken sorgular doğrudan veri gölü üzerinde, ACID garantileriyle çalıştırılabilir. Spark, Trino, Flink ve diğer motorlar aynı tabloyu paralel okuyabilir; her ekibin kendi sorgulama motorunu seçme özgürlüğü vardır.
Decoupled storage ve compute mimarisi
Storage ve compute'un ayrılması, modern bulut tabanlı analitik mimarisinin en önemli yapı taşıdır. Veri kalıcıdır ve nesne depolamada yaşar; Spark, Trino, Flink veya başka bir motor kümeleri ihtiyaç oldukça canlandırılır, iş bittikten sonra kapatılır. Bu model, klasik "her zaman açık Hadoop kümesi" pratiğine kıyasla maliyeti %40-70 düşürebilir.
Türkiye'de bu mimariyi pratiğe geçirmek isteyen şirketler, yerli bir S3 sağlayıcı ile yönetilen Spark hizmetini birleştirerek hem performans hem KVKK uyumu hem de düşük operasyonel yük elde edebilir.
Hadoop Kurumsal Kullanım Senaryoları
Log analizi ve güvenlik telemetrisi
Web sunucu logları, güvenlik duvarı kayıtları, SIEM olayları ve uygulama izleri petabayt ölçeğinde birikir. Bu veri üzerinde anomalili davranış tespiti, kullanıcı yolculuğu analizi ve uyum (compliance) raporları üretmek için Hadoop ekosistemi (HDFS + Spark + Hive) en yaygın kombinasyondur. ELK Stack veya Splunk gibi araçlar gerçek zamanlı görüntüleme sunar; Hadoop ise tarihsel derin analiz için kullanılır.
Müşteri davranış analitiği
E-ticaret tıklama akışları, mobil uygulama olayları, çağrı merkezi etkileşimleri ve sosyal medya verileri birleştirilerek 360 derece müşteri görünümü oluşturulur. Spark MLlib ile segmentasyon, churn tahmini ve öneri motoru modelleri eğitilir. Bu pipeline'lar tipik olarak günlük veya saatlik çalışır ve sonuçlar veri ambarı veya feature store'a yazılır.
ETL ve veri ambarı (data warehouse) besleme
Hadoop, kurumun farklı kaynaklarından (CRM, ERP, log sistemleri, dış API'ler) gelen ham veriyi staging katmanında saklar, temizler, birleştirir ve veri ambarına yükler. Bu mimari "ELT" (Extract-Load-Transform) yaklaşımının altyapısıdır: ham veri önce yüklenir, sonra Spark ile dönüştürülür.
Makine öğrenmesi veri seti hazırlığı
ML modellerinin başarısı büyük ölçüde eğitim verisinin kalitesine ve hacmine bağlıdır. Hadoop ekosistemi, petabayt ölçeğinde veriyi temizleme, etiketleme, özellik (feature) çıkarımı ve eğitim setine dönüştürme süreçlerini ölçeklenir biçimde destekler. PyTorch, TensorFlow veya Spark MLlib ile entegre çalışan pipeline'lar yaygındır.
Self-Managed Hadoop Cluster vs Managed Hadoop
Çok düğümlü kümenin yönetim yükü
Self-managed bir Hadoop kümesi, 5-50 sunucudan oluşan bir altyapının kurulumu, yapılandırması ve sürekli işletimini gerektirir. NameNode HA, ZooKeeper, Hive Metastore, Kerberos kimlik doğrulama, Ranger yetkilendirme, Sentry, log toplama, alarm yapılandırması — her biri ayrı uzmanlık alanıdır. Tam zamanlı en az 2-3 DevOps/SRE mühendisi gerektirebilir.
Patch, izleme ve yedekleme sorumluluğu
Güvenlik yamalarının zamanında uygulanması, Apache sürümleri arasındaki uyumluluk testleri, NameNode'un fsimage yedeklenmesi, DataNode disk dolması alarmları, YARN container OOM analizi ve Spark job tuning gibi operasyonel sorumluluklar tamamen şirketin sırtındadır. Bir patch hatası, kümenin saatlerce çevrim dışı kalmasına yol açabilir.
Cloud4U Managed Hadoop & Spark hizmeti
Cloud4U Türkiye'nin yönetilen Hadoop & Spark hizmeti, küme kurulumunu, sürüm yönetimini, patch'leri, yedekleme ve izlemeyi tamamen üstlenir. Müşteri sadece veri ve iş akışına odaklanır. İstanbul veri merkezinde çalışan küme, KVKK uyumlu ve Türkçe destekli bir altyapı sunar. POC ve ölçeklendirme süreçlerinde uzman ekiplerle birlikte çalışılır.
Türkiye'de Hadoop ve KVKK Uyumu
Yerli analitik kümesinin önemi
KVKK kapsamında kişisel veri içeren analitik iş yükleri için veri ikameti (yurt içi saklama) ciddi bir avantajdır. Yurt dışı bulutlarda analitik küme çalıştırmak, sınır ötesi veri aktarımı için ek dokümantasyon, açık rıza yönetimi ve KVKK Kuruluna sözleşme bildirimini beraberinde getirir. Yerli analitik küme bu süreçleri basitleştirir.
Finans ve telekom sektörü gereklilikleri
BDDK, BTK ve EPDK gibi düzenleyici otoriteler, bazı kişisel veri kategorilerinin Türkiye sınırları içinde saklanmasını ve işlenmesini zorunlu kılar. Bankalar, sigorta şirketleri ve telekom operatörleri için analitik altyapısının yurt içinde olması yalnızca tercih değil sözleşme şartıdır.
Türkiye veri merkezinde Hadoop avantajları
İstanbul Tier III veri merkezinde çalışan bir Hadoop kümesi, KVKK uyumu sağlar, yerli müşteri verilerine düşük gecikmeyle erişir, Türkçe sözleşme ve destek sunar. Aynı veri merkezinde S3 uyumlu nesne depolama, yerel CDN ve yedekleme hizmetleri ile entegre çalışarak end-to-end analitik mimari kurmayı kolaylaştırır.
Sıkça sorulan sorular (SSS)
Hadoop hâlâ kullanılıyor mu?
Evet, Hadoop büyük kurumlarda hâlâ aktif olarak kullanılıyor; ancak rolü artık HDFS + YARN + Spark kombinasyonu olarak şekilleniyor. Klasik MapReduce kodu nadiren yazılıyor. Yeni projelerde sıkça S3 + Spark + Iceberg gibi cloud-native alternatifler tercih ediliyor.
Hadoop ile Spark arasındaki fark nedir?
Hadoop bir ekosistem (HDFS depolama, YARN kaynak yönetimi, MapReduce işlem motoru); Spark ise bellek-içi modern bir işlem motorudur ve Hadoop kümelerinde de çalışabilir. MapReduce diske yazar, Spark mümkün olduğunca RAM'de tutar. Bugün çoğu yeni iş yükü Spark ile yazılır; Hadoop daha çok depolama ve kaynak yönetimi katmanını sağlar.
Küçük şirketler Hadoop kurmalı mı?
Hayır, küçük şirketler için Hadoop genellikle gereksiz; birkaç TB altı veri hacminde PostgreSQL, ClickHouse veya yönetilen bir analitik hizmet daha uygundur. Hadoop onlarca TB ile petabayt arasındaki ölçekte ve birden çok ekibin paralel analitik ihtiyacı olduğunda anlamlıdır. Aksi hâlde operasyonel maliyet sağlayacağı faydayı aşar.
HDFS yerine S3 kullanılır mı?
Evet, modern büyük veri mimarilerinde HDFS yerine S3 uyumlu nesne depolama kullanmak standart hâline geldi. S3 büyük dosya yönetimi avantajını korurken storage ve compute'u ayırma esnekliği sunar. Türkiye için yerli S3 sağlayıcı kullanmak KVKK uyumu açısından önemlidir.
Yönetilen Hadoop mu yoksa kendi kümem mi?
Çoğu şirket için yönetilen Hadoop daha mantıklıdır; çünkü NameNode HA, Kerberos, patch ve izleme operasyonları sağlayıcıya devredilir. Self-managed küme tam zamanlı 2-3 DevOps/SRE gerektirebilir. Sadece çok özel donanım gereksinimleri veya regülatif kısıtlar varsa kendi küme tercih edilebilir.
Cloud4U Türkiye Hadoop & Spark ile büyük veri analitiği
İstanbul veri merkezinde yönetilen Hadoop kümesi
Cloud4U Türkiye'nin yönetilen Hadoop & Spark hizmeti, İstanbul Tier III veri merkezinde çalışır. Küme kurulumu, sürüm yönetimi, güvenlik yamaları, yedekleme, izleme ve performans tuning sağlayıcı tarafından üstlenilir. Veri mühendisi ekibinizin operasyonel yükü minimuma iner, asıl iş olan veri pipeline'larına ve modellere odaklanırsınız.
KVKK uyumlu, Türkçe destek
- KVKK uyumlu İstanbul Tier III veri merkezi
- 7/24 Türkçe teknik destek ve SLA garantili çözüm süreleri
- Spark, Hive, HDFS, Iceberg ve modern ekosistem desteği
Fiyatlandırma ve ücretsiz POC danışmanlığı
İş yükünüze özel TCO hesaplaması ve POC danışmanlığı için Cloud4U Türkiye Hadoop & Spark sayfasını ziyaret edin. Uzman ekibimiz mevcut veri mimarinizi analiz eder, küme boyutlandırması yapar ve ücretsiz POC süreciyle gerçek veri üzerinde performansı test etmenizi sağlar.